[그래프DB ②] ‘앵커링’과 ‘트래버싱’으로 맥락 증명…성패 가르는 ‘모델링’
2026.02.03 14:14- 작성자 관리자
- 조회 1,610
| 잠들어 있던 그래프DB, AI 환각 방어선으로 ‘화려한 귀환’
| 지식 파편 엮는 온톨로지 기술, 지능형 에이전트 사고 설계도로 부상
5년 전, 국내 IT업계를 강타했던 기술이 있다. 바로 그래프DB(Graph Database)다. 데이터를 정형화된 틀에 가두지 않고 데이터 간의 관계를 기억한다는 점에서 그래프DB는 인간의 사고방식과 가장 닮아있다. 관계를 토대로 다양한 인사이트를 발굴할 수 있기에 혁신성을 인정받았다. 하지만 당시 국내 IT산업은 미흡한 기술 생태계와 성숙하지 못한 시장이었기에, 그래프DB는 ‘어렵고 비싼 기술’이라는 낙인이 찍힐 수밖에 없었다. 결국 뒤안길로 사라지는 듯했다.
그러나 생성형 AI의 아킬레스건인 ‘환각’ 이슈가 그래프DB를 다시 수면 위로 끌어올렸다. 지식의 체계를 정의하는 온톨로지와 관계를 추적하는 그래프DB를 결합해 AI의 불확실성을 해소할 해법으로 부상한 것이다. 이제 그래프 DB는 단순한 저장소를 넘어, AI가 비즈니스 맥락을 이해하게 만드는 ‘사고(思考)의 설계도’로 재정의되고 있다. 3회에 걸쳐 그래프DB를 조명해 본다.
‘앵커링’과 ‘트래버싱’으로 맥락 증명
그래프DB는 기술적으로 어떻게 작동하기에 기존 DB와 다른 가치를 제공할까. 이를 이해하려면 먼저 온톨로지와 그래프DB의 관계를 명확히 짚어야 한다. 온톨로지는 ‘데이터의 의미를 담은 설계도’, 그래프DB는 그 설계도를 구현해 데이터를 담는 물리적 ‘그릇’이자 ‘실행 엔진’으로 정의할 수 있다.
기존의 관계형 데이터베이스(RDB)에는 데이터가 행(Row)과 열(Column)로 이뤄진 엑셀 표와 유사한 테이블 형식으로 저장된다면, 그래프DB에는 데이터가 점과 이를 연결하는 선으로 저장된다. 데이터가 저장되는 순간부터 이미 짝(Pair)을 이뤄 연결돼 있기에, RDB라면 매번 시도돼야 하는 데이터 결합(Join)이 필요가 없다.
그래프DB에는 RDB에 없는 독특한 데이터 탐색 방식인 ‘앵커링(Anchoring)’이 존재한다. 데이터를 찾을 때 전체를 탐색하는 것이 아니라, 시작점이 되는 특정 노드를 찾아 닻을 내리듯 고정하는 전략이다. 이는 RDB 튜닝에서 쿼리의 시작점이 되는 ‘드라이빙 테이블(Driving Table)’을 찾아 효율적인 진입점을 확보하는 것과 유사한 원리다.
앵커링을 통해 진입 지점을 찾은 후에는 그 노드에 연결된 관계선을 타고 다음 노드로 이동하며 데이터를 탐색하는데, 이 과정을 ‘트래버싱(Traversing)’이라고 부른다. 마치 지하철 노선도에서 출발역을 찾은 뒤(앵커링), 연결된 선로를 따라 환승역을 거쳐 목적지까지 이동하는 것과 유사한 형식이다. 연결된 포인터만 따라가면 되기에 복잡한 관계를 추적하는 속도가 RDB에 비해 빠르다.
이러한 구조 덕분에 그래프DB는 데이터 간의 복잡한 연결 경로를 직관적으로 다룰 수 있다. 엔코아 김지영 온톨로지컨설팅팀장은 “‘가령 A 부품이 고장 났을 때 영향받는 모든 제품을 찾아줘’와 같은 질문을 RDB로 처리하기 위해선 파이썬 라이브러리를 불러와 수많은 테이블을 조인하고 복잡한 연산을 수행해야 하지만, 그래프DB에서는 사이퍼 쿼리 몇 줄로 즉시 답을 얻을 수 있다”고 예를 들어 설명했다.
성패 가르는 정교한 모델링
그래프DB가 생성형 AI 시대의 중요한 기술로 떠오르고 있다. 하지만 중요한 기술로 주목받는 만큼, 도입 난도는 높다. 구조적으로 데이터가 서로 얽혀 있기에 기존 RDB보다 훨씬 더 정교하고 치밀한 ‘모델링(Modeling)’ 작업이 필요하다.
먼저 그래프DB는 데이터를 제대로 모델링하지 않으면 ‘비용 폭탄’으로 이어진다. 그래프DB는 데이터를 저장할 때 값 외에도, 연결된 관계 정보와 주소 정보까지 미리 계산해 오브젝트화해 저장해야 한다. 저장 공간을 아끼는 것보다 빠른 속도와 연결성을 최우선 가치로 두는 셈이다. 이 때문에 별다른 모델링 없이 원천 데이터(Raw Data)를 그대로 그래프DB에 옮길 경우, 데이터 용량은 RDB 대비 통상 2.5배에서 3배까지 늘어난다. 이는 고스란히 저장소 비용 증가와 성능 저하로 이어진다.
이에 대해 업계 관계자는 “일반적인 RDB가 데이터를 서류함에 차곡차곡 쌓아두고 필요할 때마다 인덱스를 뒤져 찾아낸다면, 그래프DB는 데이터를 저장하는 순간부터 옆에 있는 데이터가 누구인지, 어디에 있는지(주소)를 미리 파악해 실로 묶는 방식이다. 즉 데이터를 찾는 것과 동시에 그 관계까지 한 묶음의 ‘객체(오브젝트)’로 꺼내 올 수 있다. 마치 내비게이션에 목적지를 입력하기 전부터 이미 모든 지름길과 연결 도로 정보를 계산해 한 장의 지도로 그려둔 것과 같은 원리다”라고 부연했다.
정교한 모델링을 했다면 그래프DB를 효율적으로 사용할 수 있게 된다. 엔코아의 프로젝트 사례에 따르면, RDB가 잘하는 영역과 GDB가 강점을 보이는 영역을 구분해 최적화한 결과, 데이터 용량 증가분을 10% 이내로 줄이는 성공 사례도 있다.
모델링은 비용 외에 검색 속도에도 큰 영향을 미친다. 그래프DB는 연결이 무한하게 발생할 수 있어 이 문제를 극복하기 위한 ‘탐색 전략(Access Strategy)’이 필요하다. 데이터 모델링 과정에서 탐색 전략을 수립해 검색 속도를 유지할 수 있다. 통상 그래프DB는 노드와 노드를 건너뛰는 ‘홉(Hop)’ 수가 늘어나거나, 탐색해야 할 공간(Search Space)이 지나치게 넓어지면 속도가 급격히 느려진다. 무작정 데이터를 많이 연결한다고 좋은 것이 아니라는 의미다.
RDB가 테이블 정규화를 통해 중복을 제거하는 데 집중한다면, 그래프DB 모델링은 중요한 관계들을 어떻게 구성할지 전략을 짜는 게 중요하다. 사용자가 어떤 질문을 던질지 예측하고, 인덱스 전략과 액세스 전략을 세밀하게 튜닝해 탐색 범위를 조절하지 않으면 대용량 데이터 환경에서 제 성능을 낼 수 없다.
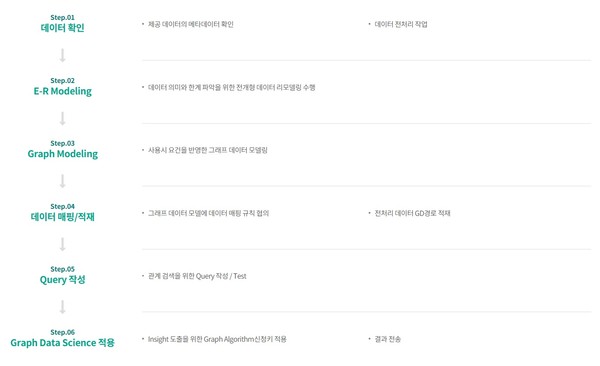
엔코아가 제시하는 그래프 DB 구축 방법론 (출처: 엔코아)
RDB와 그래프DB의 데이터 모델 설계 방식은 큰 차이가 없다. 개념과 관계를 파악해 정해진 표기법(ERD/Graph schema)으로 데이터 구조를 기술한다. 그래프 도입 활용 목표를 먼저 명확히하고 그래프 구축 범위와 구조를 설계해야 한다. 그래프를 도입해서 할 수 있는 분석과 응용의 범위가 매우 다양해 사용자는 사전에 활용 목표를 명확히 설정하기 어려울 수도 있다.
RDB로 데이터 관계 표현 가능…복잡도 및 성능에 한계
현재 그래프DB는 국내에서는 활성화되지 못한 상태이다. 그래프DB는 많은 이점이 있음에도 불구하고 시장 확산에 제약이 있다. 업계에 따르면, 그래프DB 도입을 검토하는 실무자들은 “굳이 새로운 DB를 도입해야 하는가, 기존에 잘 쓰고 있는 RDB로도 관계를 표현할 수 있지 않나”라는 질문을 가장 먼저 던지는 것으로 알려진다. 결론부터 말하자면 “가능은 하지만, 복잡도와 성능의 한계가 명확하다”는 것이 업계 관계자들의 진단이다.
먼저 RDB는 관계를 정의하고, 그래프DB는 관계를 기억한다. RDB는 관계형 데이터베이스라는 이름 그대로 데이터 간의 관계를 정의한다. 하지만 RDB는 테이블과 테이블을 연결할 때 외래키(Foreign Key)를 사용하며, 데이터를 조회하는 시점에 ‘런타임 조인(Runtime Join)’을 수행해야 한다. 즉 질문을 던질 때마다 매번 관계를 계산해서 붙여야 한다는 의미다.
친구의 친구, 그 친구의 또 다른 친구를 찾는 식으로 관계의 깊이(Depth)가 깊어질수록 RDB는 기하급수적으로 연산량이 늘어나는 ‘데이터 조인’ 폭탄을 맞게 되지만, 그래프DB는 이미 연결된 선만 따라가면 되기에 성능 저하가 거의 없다.
데이터 분석을 위한 비용과 편의성에도 차이가 존재한다. 복잡한 네트워크 분석이나 경로 추적을 RDB로 수행하려면, 데이터를 꺼내와서 별도의 애플리케이션 단에서 파이썬(Python) 라이브러리 등을 활용해 연산해야 한다. 이는 개발 복잡도를 높이고 유지보수를 어렵게 만드는 요소다. 반면 그래프DB는 사이퍼와 같은 자체 쿼리 언어를 통해 몇 줄의 명령어만으로 최단 경로 탐색, 중심성 분석 같은 고도화된 알고리즘도 즉시 실행할 수 있다.
또한 스키마의 유연성도 다르다. RDB는 사전에 정의된 엄격한 스키마(Schema)를 따라야 한다. 새로운 관계 유형이 생기거나 속성이 추가되면 테이블 구조 전체를 변경해야 하는 부담이 있다. 스키마는 DB에 어떤 데이터가 들어갈지, 데이터 간의 관계는 어떠한지, 어떤 규칙을 따라야 하는지를 규정한 것이다. 반면 그래프DB는 스키마를 유연하게 가져갈 수 있기에 데이터 구조가 수시로 변하는 MSA 환경이나 비정형 데이터 분석에 훨씬 유리하다.
아이티데일리 박재현 기자
기사 원문 보기 [그래프DB ②] ‘앵커링’과 ‘트래버싱’으로 맥락 증명…성패 가르는 ‘모델링’
| 다음글 | [그래프DB ③] ‘그래프 RAG’로 환각 차단 가능…RDB 대체재 아닌 상보 관계 | 2026-02-03 |
|---|---|---|
| 이전글 | [그래프DB ①] 아리스토텔레스부터 네오포제이까지, 시대를 기다린 ‘지식의 망’ | 2026-02-02 |